equipo desarrollo

Varnish es un “caching HTTP reverse proxy”, vamos, que cachea los objetos HTTP enteros, con sus cabeceras, cuerpo, etc. Además se suele usar como balanceador, es decir, por cada request que reciba y que no tenga ya guardada, es suficiente inteligente como para enviar a distintos backends (de una lista que tenga configurada) cada petición para obtener de ellos la respuesta.
En idealista usamos varnish en distintas partes de la web, en concreto hoy vengo a hablaros de uno de los usos que le damos en idealista/news, para evitar en la medida de lo posible caídas del portal o al menos llevar sus efectos al mínimo para nuestros usuarios.
¿Cómo puede ayudar Varnish si nuestro backend está en mal estado?
Varnish recibe las peticiones http y se las envía a un backend o grupo de backends (balanceo) para obtener la respuesta. Cada máquina que responde a varnish es un backend, dependiendo de la arquitectura podrá ser otro varnish, una máquina con un servidor web como nginx o apache, etc.
Como diría Cruyff, en un momento dado este backend puede no estar en las mejores condiciones, no necesariamente caído del todo, pero quizás tiene mucha carga por un pico de tráfico (efecto promoción de entradas de Renfe, sí, todos las sufrimos), o la base de datos de nuestra aplicación no responde, o cualquier otra causa.
Varnish dispone de un estado de gracia “grace mode”, que nos permite devolver una versión almacenada en caché cuando no hay ningún backend disponible.
Osea que nuestro portal puede estar roto rotísimo pero nuestros usuarios ni enterarse. Suena bien, ¿no?
Flujo de una petición en Varnish
Vamos a recapitular un poco y explicar el flujo de una petición http en distintos escenarios.
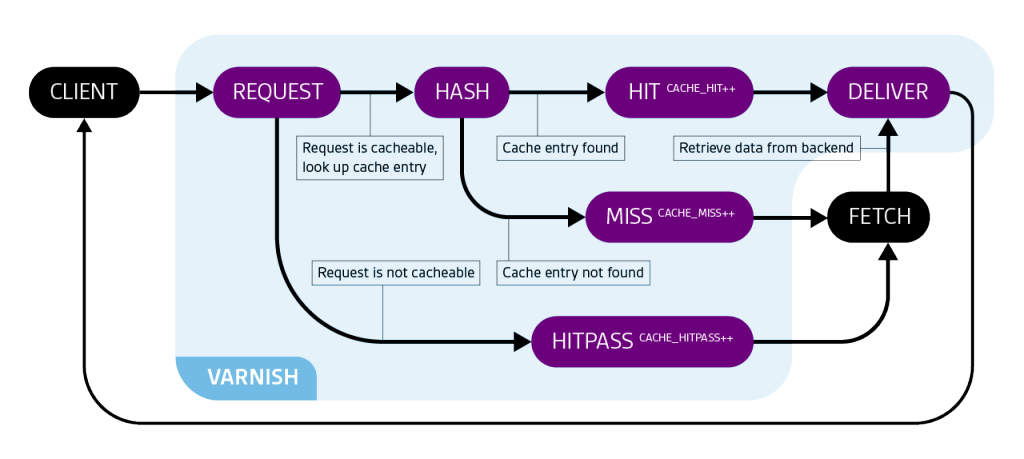
Lo primero es lo que pasa cuando todo va bien.
Entra la petición a Varnish, podemos definir si es una petición que requiere contenido no cacheado (por ejemplo porque tiene una cookie de sesión) en cuyo caso iremos a buscar su contenido a backend (Fetch), o puede que sea cacheable (un usuario anónimo).
Si es cacheable se genera un identificador hash (generalmente a partir de la URL) para buscar el objeto en caché, si no está guardado en caché (miss), se irá a buscar su respuesta al backend definido y la respuesta http se almacena asignándole un tiempo de vida (ttl), es decir un tiempo en el que Varnish puede considerar a ese objeto http como “fresco”. Además especificamos que ese objeto tiene un tiempo de gracia para usar en caso de emergencia, esta variable es clave.
La siguiente vez que entre una petición cacheable y con el mismo identificador (la misma URL), si tenemos el objeto guardado (hit) dentro del tiempo de frescura podremos devolverlo sin tener que ir a generar la respuesta a backend. Si ha pasado ese tiempo, aunque aún no se haya cumplido el tiempo de gracia, iremos a refrescar el objeto buscándolo en backend nuevamente.
Y de repente nuestro backend empieza a fallar…
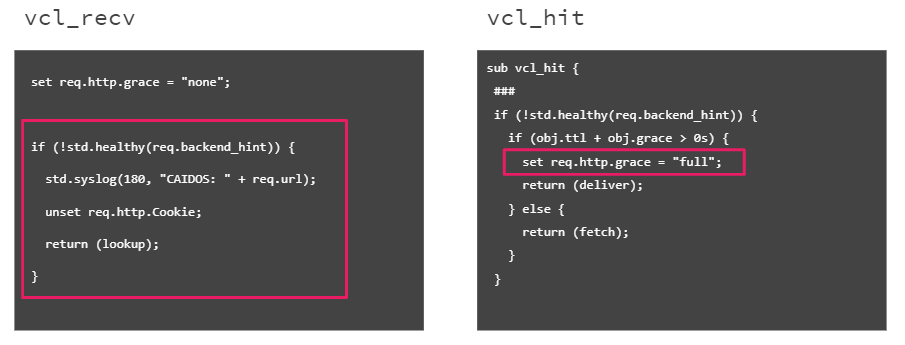
En este caso podemos definir que todas las nuevas peticiones sean devueltas con la versión de caché en caso de tenerla. Esto lo hacemos en vcl_recv por ejemplo quitando las cookies para que no tenga sesión.
El tiempo de frescura seguirá pasando, pero podremos recurrir al tiempo de gracia, al cual marcaremos como ilimitado mientras dure el tiempo de inestabilidad. Esto lo hacemos en vcl_hit que es donde entra el flujo cuando se ha encontrado una versión de caché (puede que el ttl ya esté caducado pero que siga teniendo grace).
Resumiendo, tenemos el backend inestable, caído, roto, como quieras llamarlo, y varnish al detectarlo devolverá la versión cacheada, la de los anónimos, hasta que el backend (o uno de ellos) vuelva a estar disponible.
Varnish sabe que no tiene backends sanos llamando a std.healthy y pasándole el backend(s).
https://info.varnish-software.com/blog/grace-varnish-4-stale-while-revalidate-semantics-varnish
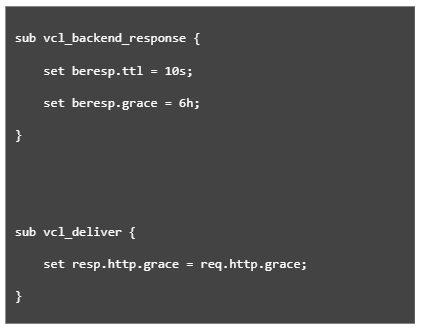
El ttl que especificamos en la directiva vcl_backend_response es el tiempo de frescura del que hablamos y el grace es el tiempo de gracia y que usaremos para guardar la respuesta http en la caché de Varnish..
Mola, ¿no? Podemos irnos a por un café y resolver el problema con calma!

Vale, sabemos que esta solución no valdrá para todos los portales, pero en muchos sites la diferencia entre la versión de caché y la de anónimo es un nombre de usuario escondido arriba a la derecha en un menú… o quizás que puedas rellenar un formulario de comentarios o similar, que puede que sea una funcionalidad prescindible en momentos de pánico.
Es más, si fuéramos a páginas construidas con ESI en varnish, podríamos tener en ESI estas partes de la página, digamos el formulario, y cuando detectemos que estamos caídos no devolver otra versión por ejemplo para que al pulsar en “Enviar” carguemos por javascript una capita que te diga que no estamos disponibles en estos momentos en vez de que “explote” toda la página.
Repito, son soluciones para momentos de crisis, nuestros servidores se han ido de paseo, hemos subido un bug que produce un 500 en todas las peticiones, el disco se ha llenado… no sé, esas cosas que pasan… seguro que tú tienes tu ejemplo.
¿Cómo sabe Varnish que el backend está inestable?
Varnish tiene unos ficheros de definición de backends donde se dice su ip, puerto al que conectarse, etc.
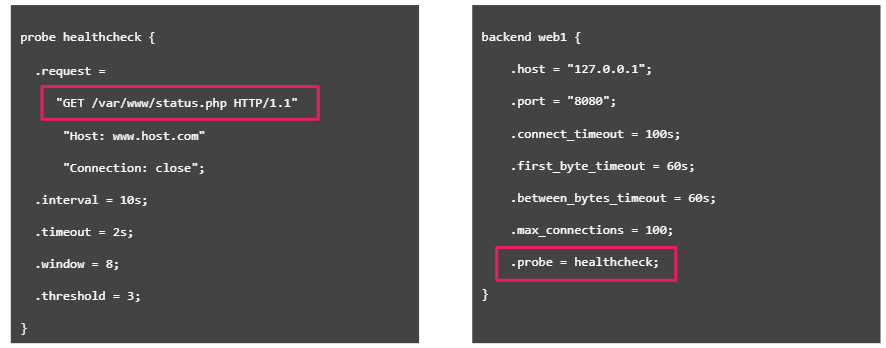
Entre dichas variables se puede añadir una “prueba de salud”.
Esta prueba tiene su propia especificación configurable, por ejemplo para especificar cada cuánto queremos que se ejecute y la dirección http de la prueba.
Toda prueba que no responda con un código 200 marcará a ese backend con inestable hasta la siguiente prueba.
https://www.varnish-cache.org/docs/4.0/reference/vcl.html#probes
https://www.varnish-cache.org/docs/4.0/reference/vcl.html#backend-definition
¿Y qué es esta prueba?
Pues podemos decir a varnish que haga una petición a un fichero .php y en este fichero comprobar que nuestra base de datos está levantada, que la carga del servidor es aceptable, etc. Es más, gracias a esto podemos escribir en un fichero de log cuál o cuáles son los problemas detectados en el script y de esta manera ir al grano para solucionarlo.
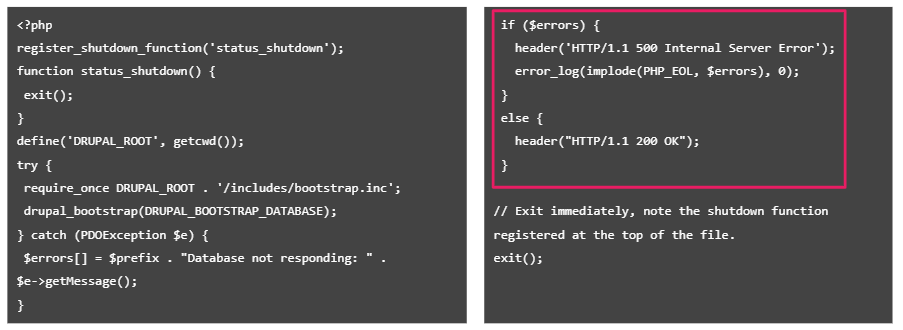
En idealista/news tuvimos una temporada en el que cada día nos caíamos durante unos minutos coincidiendo con el envío de la newsletter diaria. Pues con esta prueba podíamos detectar que las máquinas empezaban a sobrecargarse y decidir enviar la versión de anónimos a nuestros usuarios, mejor solución que esperar a que el sistema termine por colapsar ¿no crees?
Hoy gracias a otras mejoras en nuestra infraestructura hacen que esto no sea necesario, al menos a diario, pero en aquellos tiempos hizo que ganáramos años de vida en el equipo.
Pero no solo para estos escenarios o caídas generales. Es útil para procesos de upgrade del sistema en el que normalmente tendríamos que tener tu site en modo de mantenimiento o similar, por ejemplo mientras actualizamos la versión de PHP tenemos unos segundos inaccesible el site, por aquello de que borras una versión y después se instala la nueva. Con este sistema en vez de devolver la página de error del portal podemos devolver la de anónimo a todos los usuarios.
Otros recursos
Si te interesa conocer otros aspectos de Varnish, te recomiendo ver la charla que di en la DrupalCamp de 2016
- https://vimeo.com/167777106
- https://2016.drupalcamp.es/sites/default/files/slides/Varnish%20para%20meros%20mortales.pdf
También te dejo estos enlaces para ampliar
- https://info.varnish-software.com/blog/grace-varnish-4-stale-while-revalidate-semantics-varnish
- https://www.varnish-cache.org/docs/4.0/reference/vcl.html#probes
- https://www.varnish-cache.org/docs/4.0/reference/vcl.html#backend-definition
- https://www.lullabot.com/articles/configuring-varnish-for-highavailability-with-multiple-web-servers#/