equipo desarrollo

En el primer post de esta serie sobre construcción de sistemas de Machine Learning (ML) vimos que se trata de un proceso que comparte muchos de los retos del desarrollo del software pero con una serie de peculiaridades como la naturaleza no lineal de la construcción del modelo, y el propio nivel de incertidumbre de la fase de diseño.
Cuando hablamos de incertidumbre nos referimos a que por un lado las herramientas para resolver el problema están en la justa combinación entre el dato, nuestro conocimiento del negocio y los algoritmos que vamos a aplicar. El modelo debe replicar una realidad: ¿cómo consumen nuestros usuarios?, ¿cómo de probable es que este usuario sea fraudulento? o ¿cómo de descontento está mi cliente?
A veces el dato está contaminado con sesgos de origen o requiere de una potabilización para que nuestros algoritmos los puedan consumir. Otro punto importante es la naturaleza de los datos, muchas veces su escasez nos obliga a usar técnicas más cercanas a la estadística tradicional y, en otras, en abundancia de datos podemos dejar nuestra solución más en manos de la fuerza bruta de la máquina. Este tipo de casuísticas añaden incertidumbre al proceso, dificultando el análisis y planificación de la solución.
A continuación compartimos lecciones aprendidas y ponemos encima de la mesa una serie de reflexiones en base a nuestra experiencia en el desarrollo de productos de datos.
¿REALMENTE NECESITAS ML PARA MEJORAR TU PRODUCTO?
Cuando nuestr@s compañer@s de producto nos piden colaborar para ver cómo podemos mejorar un servicio a través del uso de los datos el proceso que seguimos es algo así: Una vez que entendemos el problema de negocio que queremos solucionar (puede requerir múltiples reuniones) y comprobamos que tenemos un mínimo de datos de suficiente calidad comenzamos a diseñar una primera iteración. Y en este punto es cuando nos preguntamos qué solución técnica es óptima.
Y cuando decimos óptima, no nos referimos a la solución perfecta. A veces cruzar un conjunto de datos a través de unas queries de SQL y dejarlos disponibles en una tabla para que otro servicio lo consuma es suficiente. Otras veces proporcionamos simulaciones con estos datos para dotar al usuario de una serie de palancas que le permita decidir cómo actuar. Y otras veces consideramos que un modelo de ML puede suponer un salto de calidad para el servicio, pero siempre teniendo en cuenta lo que hemos tratado al principio de este post, la complejidad (costes) que supone desarrollar, operativizar y mantener un sistema basado en ML.
UN PIPELINE ROBUSTO TE EVITARÁ SORPRESAS INESPERADAS
«No machine learning model is valuable, unless it’s deployed to production«
Luigi Patruno, autor del blog ML in Production
Compartimos filosofía con Luigi Patruno, y para aplicarla seguimos una serie de prácticas que están muy alineadas con las Google ML Rules (y de las que nos consideramos muy fans). Una vez que nos hemos decidido a usar un modelo de ML tratamos siempre de partir de una aproximación sencilla y desarrollable en una prueba piloto que nos permita comprobar la calidad de los datos necesarios y tener un baseline del desempeño del modelo.
El siguiente paso no es iterar y mejorar el modelo. El siguiente paso es construir un pipeline completo que incluya la adquisición de los datos, su preparación, el entrenamiento del modelo y su empaquetado para ser desplegado. Aquí es necesario llevar a cabo un control riguroso de la traza del dato, el funcionamiento del código, el desempeño offline del modelo y las dependencias. En la siguiente imagen se pueden ver los tests que requiere un pipeline completo.

En paralelo al desarrollo del pipeline tratamos de coordinarnos con los equipos que van a consumir las predicciones que realiza el modelo para que lo vayan integrando en la aplicación que lo consume. Es importante hacer esto cuanto antes para descubrir tanto problemas técnicos (enganches con el modelo, formatos, librerías…) y organizativos (a veces no está muy claro quien se tiene que encargar de hacer estos desarrollos y surgen fricciones entre los equipos o sus prioridades).
AUTOMATIZA EL PIPELINE Y AÑADE TRIGGERS

Cuando el pipeline ya está montado, trabajamos en su automatización completa (para ello usamos Airflow) y en desarrollar una serie de disparadores que nos permitan actualizar y desplegar una nueva versión del pipeline completo.
Esto nos permite sustituir el modelo en producción de manera ágil en distintas circunstancias:
- De manera discrecional: Porque hemos mejorado el modelo y queremos incorporar dichas mejoras.
- Cuando existan nuevos datos disponibles: Porque los datos que se utilizan en el entrenamiento se han actualizado y tenemos más observaciones y más recientes.
- De forma periódica: Podemos definir unos intervalos en los que reentrenar el modelo y ponerlo a competir con los modelos en producción.
- Cuando hay cambios en la distribución de los datos en producción: Este es uno de los disparadores más complicados de implementar de forma automática y robusta. Se trata de comparar la distribución de los datos que se están utilizando para la inferencia con los datos utilizados en el entrenamiento y cuando se desvíen de manera significativa, disparar el pipeline completo para incorporar esos nuevos datos al entrenamiento del modelo.
EL GOBIERNO DEL DATO ES FUNDAMENTAL
Estamos hablando mucho de modelos y componentes ingenieriles del sistema de ML, pero no hay que olvidarse de los datos como input fundamental del sistema. Una buena gobernanza del dato permite trazar cómo se ha generado el mismo y controlar qué sistemas lo utilizan. De esta forma l@s científic@s de datos pueden entender mejor cómo se ha generado la información de cara a combinarla y construir nuevas variables, entender sus debilidades o realizar hipótesis sobre cómo afecta su inclusión en un modelo. Además la gobernanza permite identificar qué sistemas se ven impactados si surge un problema en la fuente o se cambia alguna lógica en la adquisición del dato.
Un aspecto relacionado al gobierno de datos es el control sobre los metadatos generados por el sistema: Qué modelos hay disponibles, cuáles están en producción, dónde están alojados los ficheros que conforman el modelo, quién y cuándo se entrenaron y cuáles eran las métricas de error de los modelos. Un repositorio de metadatos y un registro de modelos son dos componentes fundamentales del sistema para asegurar la reproducibilidad de los mismos y llevar un control sobre los experimentos realizados (recordar lo que no ha funcionado puede ser tan importante como saber qué funciona mejor).
FEATURE STORE: REAPROVECHA Y GOBIERNA MENOS – GOBIERNA MEJOR
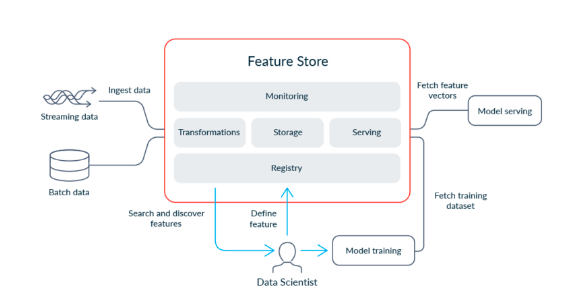
Generar variables adecuadas para nuestros productos de datos es una de las tareas más costosas debido al tiempo de desarrollo necesario por parte de ingenieras y científicas de datos. Esta es una de las razones fundamentales para mantener un almacén centralizado de variables (feature store), ya que permite reutilizar estas variables en múltiples modelos y soluciones. Además de evitar silos de información y no reinventar la rueda, de esta forma se tiene que gobernar una menor cantidad de datos. La otra razón fundamental es poder tener una definición única de las variables que evite el sesgo entre el entrenamiento y la inferencia. Una discusión detallada sobre el Feature Store se puede encontrar este post de Tecton.
MONITORIZA AL DETALLE
Una vez que hemos puesto los sistemas en producción es importante monitorizar cómo están funcionando. Un primer paso es calcular qué errores está cometiendo el sistema a la hora de realizar la inferencia. Para ello es importante tener una visión general del desempeño del modelo pero también añadir una visión sobre cómo se comporta en distintos segmentos de la población. Es posible que una actualización del modelo mejore sus métricas de manera general pero penalice algún segmento en concreto. Para ello es necesario incorporar el conocimiento experto y monitorizar con más cuidado aquellos segmentos que sean más importantes desde un punto de vista de negocio.
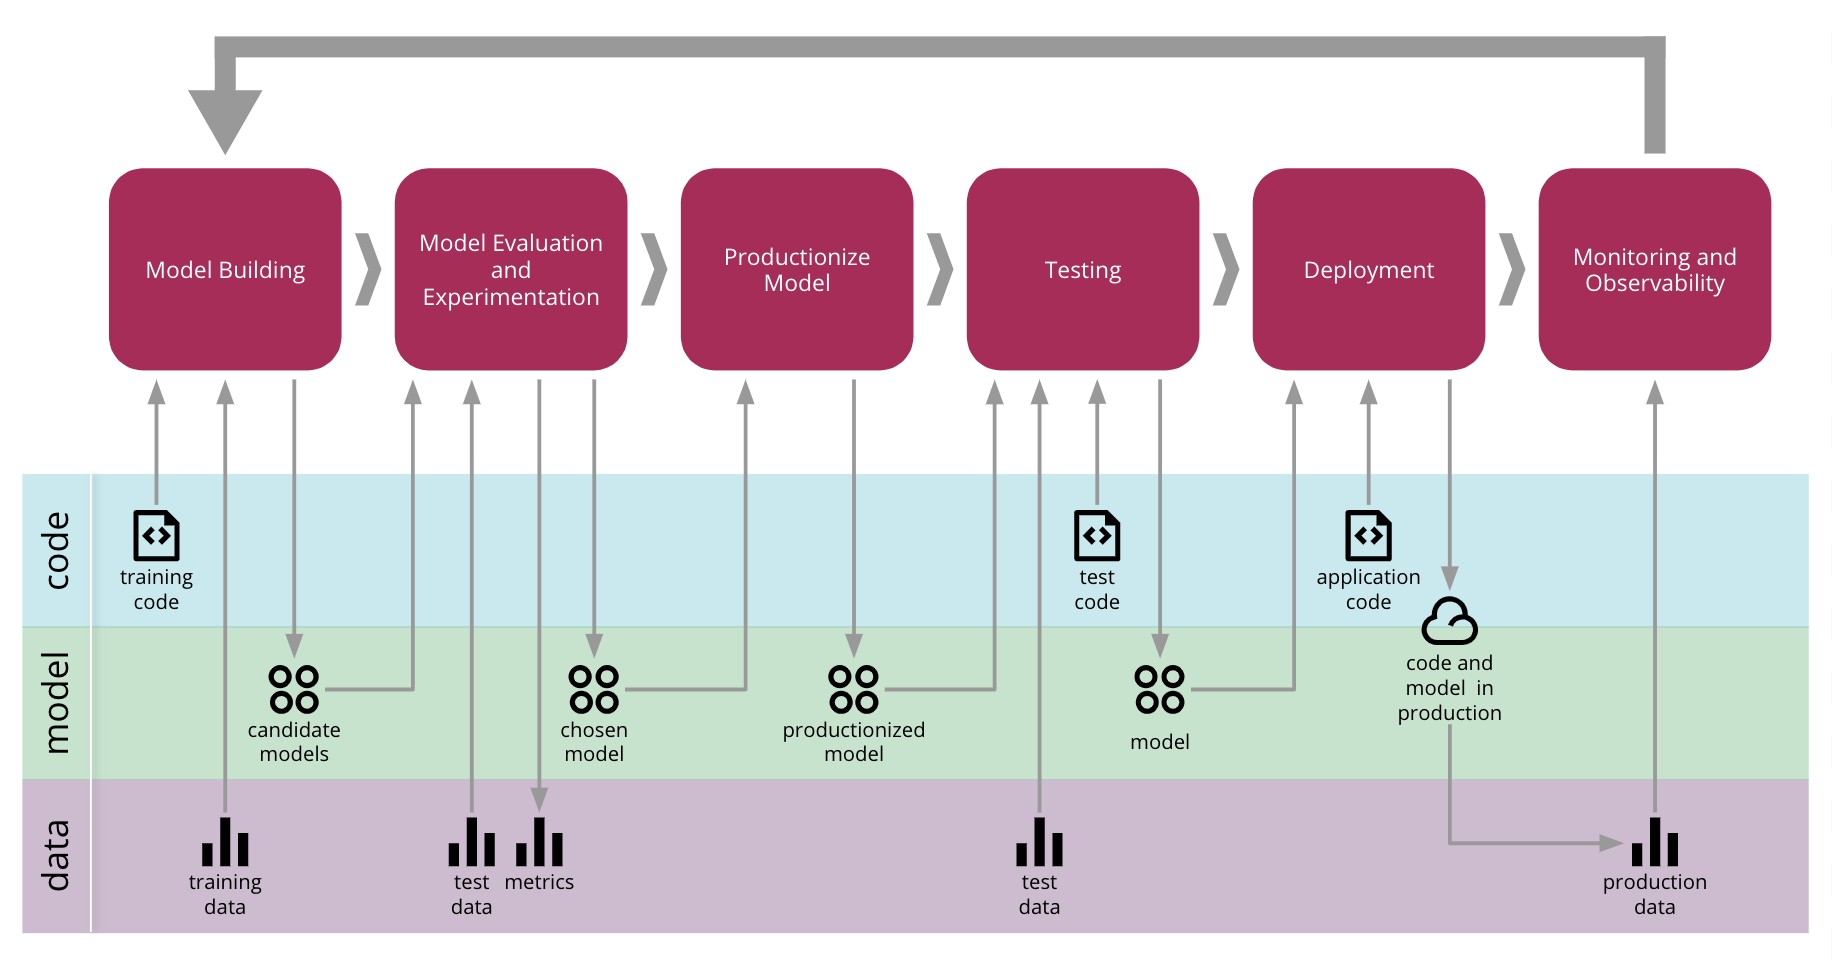
Existen múltiples problemas que pueden surgir en producción, algunos hacen que el servicio falle y son más fáciles de detectar como por ejemplo, los provocados por cambios en los esquemas de datos o los bugs en el código. Existen otros problemas que empeoran la calidad de las predicciones y requieren una monitorización particular. Es el caso de la degradación del modelo o cambios en la distribución de los datos utilizados como input para la inferencia. Estas situaciones suponen un reto operativo y requieren una muy buena implementación de la monitorización.
END-TO-END DS
Un apunte sobre la organización del equipo. El desarrollo e implantación del Sistema de ML necesita de una gran variedad de funciones que caen en el ámbito de trabajo de perfiles distintos como Data Engineers, Data Scientists, DataOps, ML Engineers y Desarrolladores de Software. Nuestra aproximación hasta el momento ha sido tratar de realizar los proyectos minimizando el número de personas y perfiles, centralizando el trabajo en el perfil de Científico de Datos.
Este modelo funciona únicamente con perfiles de Ciencia de Datos Senior y generalistas para responsabilizarse del mayor trozo de pipeline posible. En algunos foros se llama a este perfil Artesano, (en otros End-to-End Data Scientist) y suele ser de un perfil más de tipo B, que de tipo A . Somos conscientes de que en este caso perdemos muchas ganancias en productividad derivadas de la especialización y dificultad que supone para perfiles más junior o de tipo A. Pero hemos primado la velocidad de desarrollo y evitar los costes de coordinación y asimetrías de información que se introducen cuando personas de distintos departamentos colaboran en un proyecto.
Una forma de reducir estas fricciones es a través de la creación de herramientas y plataformas que faciliten y homogenicen las labores más ingenieriles y que permitan a los DS trabajar de manera muy ágil, autónoma y sin sufrir (demasiado) los problemas técnicos. Esta aproximación es utilizada por empresas como Stitch Fix tal y como cuentan en cómo organizan sus equipos de Data Science y cómo construyen data platform.
En este sentido en el último año hemos avanzado bastante en la construcción de plataforma de datos para abstraer a Data Scientists de las labores más tediosas e ingenieriles (generación de metadatos, controles de calidad automáticos, generación de DAGs automática para Airflow…). Esperamos compartirlo en un post futuro.
Para concluir, la clave de que todo funcione es una integración entre todos los pasos del proceso, tanto desde un punto de vista de las personas como de los sistemas que intervienen. Entender este proceso de principio a fin facilita que el tiempo transcurrido entre la construcción y la puesta en producción se acorte, acelerando la capacidad de producir más productos de datos y mejorarlos de forma continua.